Discutez de votre cas d’usage Local AI avec Copaco.
Avec Local AI, les clients développent et exécutent des modèles d’IA au sein de leur propre environnement, avec davantage de contrôle sur les données, les performances et les coûts. Pour les revendeurs, une nouvelle catégorie entre le PC IA classique et l’infrastructure lourde de centre de données.

Avec l’IA locale, un modèle d’IA s’exécute sur le matériel de l’organisation elle-même. Le système peut se trouver sur un bureau, dans une salle de serveurs ou à proximité d’une machine ou d’une caméra. Les données ne doivent pas être envoyées à un service d’IA externe pour chaque requête, analyse ou prédiction.
Les systèmes compacts de cette catégorie utilisent le NVIDIA GB10 Grace Blackwell Superchip. Ils combinent un processeur Arm, un GPU Blackwell, 128 Go de mémoire partagée et une pile logicielle d’IA dans un boîtier compact. Les développeurs peuvent ainsi tester et utiliser localement des modèles plus grands que sur de nombreux PC classiques.
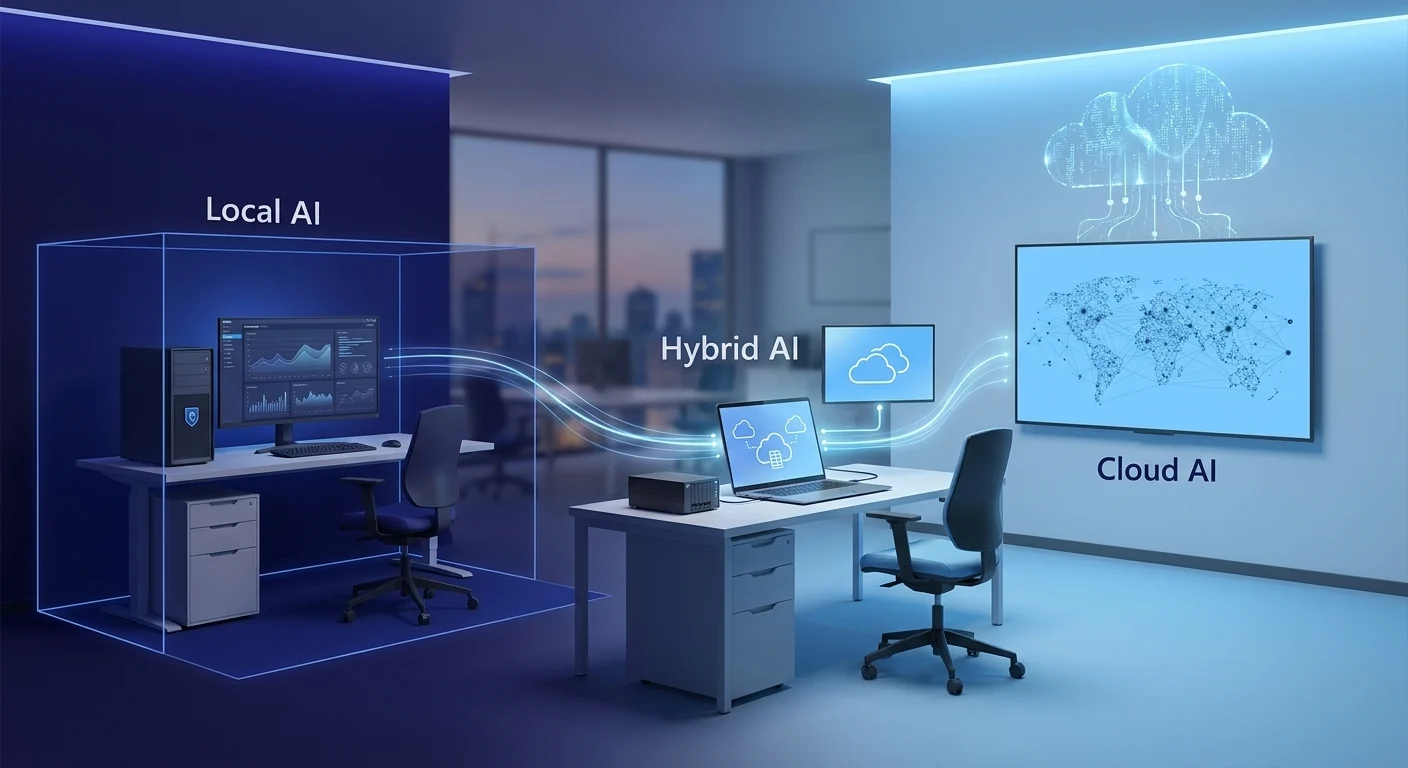
L’IA locale ne signifie pas que le cloud disparaît complètement. Les modèles, les mises à jour logicielles ou les sources de données externes peuvent toujours nécessiter une connexion internet. Une application développée localement peut également être transférée ultérieurement vers un centre de données ou un environnement cloud.
Les éditeurs de logiciels, les instituts de recherche et d’autres organisations travaillent souvent avec des données qu’ils ne souhaitent pas traiter à l’extérieur. En hébergeant le modèle et les données en local, ils peuvent mieux contrôler l’endroit où les informations sont stockées et traitées. Faire fonctionner le système en local ne constitue toutefois pas une garantie automatique en matière de confidentialité ou de conformité. Les comptes, les sauvegardes, la journalisation, les téléchargements du modèle et les sources de données connectées doivent également être configurés de manière sécurisée. L’ensemble du flux de données reste déterminant.
Le traitement local évite un aller-retour réseau supplémentaire vers un environnement externe. C’est intéressant lorsque des réponses rapides sont nécessaires, lorsqu’une grande quantité de données est générée directement par une machine ou lorsque la connexion internet n’est pas toujours fiable. Pensez à l’analyse d’images dans un environnement de production ou à un assistant qui parcourt de volumineux documents internes. La vitesse réelle dépend du modèle choisi, de la quantité de données en entrée et du nombre d’utilisateurs simultanés. C’est pourquoi un test en conditions réelles doit faire partie de tout conseil sérieux.
Le cloud, l’IA et les API facturent souvent à l’usage. C’est flexible, mais en cas d’utilisation quotidienne et intensive, les coûts peuvent fortement varier. Un système local nécessite un investissement initial. Ensuite, le matériel, l’énergie, la gestion et le support sont plus faciles à budgétiser. L’IA locale n’est pas toujours moins chère. En cas d’utilisation sporadique ou de pics temporaires importants, la capacité cloud peut être plus intéressante. Comparez donc les coûts totaux sur plusieurs années et tenez également compte de la gestion, du support et des solutions de secours.
Le supercalcul local pour l’IA est particulièrement pertinent pour les clients qui disposent d’une charge de travail d’IA concrète et d’une maîtrise technique suffisante :
Les entreprises de logiciels qui souhaitent traiter localement leur code source, leurs données de test et leurs propres modèles.
Les développeurs et équipes d’IA qui ont besoin d’un environnement fixe pour le développement, le RAG, l’inférence et le fine-tuning.
Les établissements d’enseignement et de recherche qui souhaitent donner à leurs étudiants ou chercheurs accès à des capacités locales d’IA.
Les entreprises d’ingénierie qui souhaitent utiliser l’IA pour des images, des documents, des données de capteurs ou des flux de travail techniques.
Les organisations soumises à des exigences en matière de confidentialité, de sécurité ou de souveraineté des données.
Les organisations qui utilisent l’IA quotidiennement et souhaitent mieux maîtriser leurs coûts d’utilisation récurrents.
Dressez l’inventaire du modèle, des sources de données et de la tâche d’IA souhaitée.
Déterminez combien d’utilisateurs travailleront simultanément et quel temps de réponse est nécessaire.
Vérifiez que tous les conteneurs, bibliothèques et intégrations prennent en charge Arm64.
Calculez l’espace de stockage nécessaire pour les modèles, les jeux de données, les embeddings, les points de contrôle et les journaux.
Définissez qui prend en charge la sécurité, les mises à jour, la surveillance, les sauvegardes et le support.
Comparez le coût total d’une solution locale avec ceux d’un scénario cloud et hybride.
Testez la solution avec de véritables données clients et mesurez la qualité, la latence et la capacité.
L’inférence locale convient aux applications telles que la synthèse, la classification, l’analyse de documents, l’assistance au codage et les assistants de chat internes. Grâce au RAG, un revendeur peut y ajouter ses propres informations clients, par exemple des manuels, des documents de projet, des tickets d’assistance ou des politiques internes.
Une bonne solution RAG ne se limite pas à un modèle de langage. Il faut également mettre en place l’extraction des documents, la technologie de recherche, les droits d’accès, la citation des sources et la mise à jour de la base de connaissances.
Les développeurs peuvent comparer des modèles localement, tester des prompts, créer des agents et essayer de nouvelles applications. L’environnement de développement fixe permet d’expérimenter sans devoir démarrer des ressources cloud pour chaque test.
Les systèmes GB10 fonctionnent sous DGX OS et reposent sur une architecture Arm64. La compatibilité des conteneurs, bibliothèques et logiciels d’entreprise existants doit donc être vérifiée au préalable.
Le réglage fin permet d’adapter un modèle existant à un domaine, un style d’écriture ou une tâche récurrente. Les méthodes économes en paramètres, telles que LoRA, conviennent particulièrement bien aux systèmes compacts d’IA locale. L’entraînement complet de grands modèles de base nécessite généralement un environnement multi-GPU plus puissant.
En vision par ordinateur, l’IA traite des images ou des vidéos. Les exemples incluent le contrôle qualité, la détection d’objets, l’OCR et l’analyse d’images techniques. Le traitement local est pertinent lorsque les données vidéo ne peuvent pas être envoyées à l’extérieur ou lorsqu’une réaction rapide est nécessaire.
Le nombre de caméras, la résolution, le nombre d’images par seconde et le modèle utilisé déterminent la capacité nécessaire. Testez donc toujours avec le flux de données réel.

Un bon conseil indique également dans quels cas une autre plateforme est plus adaptée. Local AI est moins approprié lorsque :
le client n’utilise l’IA qu’occasionnellement et peut réduire sa capacité cloud à zéro ;
la charge de travail connaît des pics très importants ou imprévisibles ;
l’organisation souhaite entraîner entièrement de grands modèles de fondation ;
les logiciels essentiels ne sont disponibles que sur Windows ou x86 ;
le service a immédiatement besoin d’une haute disponibilité et d’une mise à l’échelle sur plusieurs sites ;
personne n’est responsable des mises à jour, de la sécurité, des sauvegardes et de la gestion des modèles.
Dans de telles situations, une solution cloud basée sur l’IA ou une solution hybride peut être plus logique.
L’ASUS Ascent GX10, l’Acer Veriton GN100, le MSI EdgeXpert, le HP ZGX Nano, le Dell Pro Max avec GB10 et le Lenovo ThinkStation PGX reposent sur la même architecture de plateforme NVIDIA GB10.
La base commune se compose d’un processeur Arm à 20 cœurs, d’un GPU Blackwell intégré, de 128 Go de mémoire unifiée cohérente et de NVIDIA DGX OS. NVIDIA annonce jusqu’à 1 PFLOP de performances en IA en FP4 avec parcimonie. Un système est positionné pour des modèles comportant jusqu’à 200 milliards de paramètres. Deux systèmes reliés peuvent prendre en charge des modèles plus volumineux, jusqu’à 405 milliards de paramètres.
Ces chiffres nécessitent quelques explications ; le 1 PFLOP constitue une valeur de pointe théorique à une précision donnée. Le nombre de paramètres indique surtout si un modèle peut tenir dans l’environnement disponible. Il ne garantit ni la vitesse, ni la qualité, ni le nombre d’utilisateurs que le système peut prendre en charge.
Système | Variantes de stockage* | Différence pertinente | À sélectionner principalement selon |
ASUS Ascent GX10 | 1, 2 ou 4 To | Plusieurs options de stockage et conception thermique propriétaire. | SKU, stockage et assistance. |
Jusqu’à 4 To | Certains SKU comprennent un câble QSFP et un clavier. | Pack exact et disponibilité. | |
1 ou 4 To | Positionnement edge/industriel et montage en rack en option. | Emplacement, refroidissement et accessoires. | |
1 ou 4 To | HP ZGX Toolkit ; utilisation sur poste de travail et en périphérie. | Logiciels, assistance et stockage. | |
1, 2 ou 4 To | Large choix de SSD et SSD remplaçable documenté. | Type de SSD, maintenance et assistance. | |
1 ou 4 To | DGX OS, AI Workbench et positionnement ThinkStation. | Gestion, pack et assistance. |
**Les configurations, les accessoires inclus et la disponibilité peuvent varier selon le pays et le numéro de pièce.*
Sur la base des spécifications officielles, rien ne permet de présenter une marque comme étant systématiquement plus rapide. Pour le revendeur et le client final, le stockage, le refroidissement, le pack, la garantie, l’assistance, la gestion et le délai de livraison sont probablement plus importants.
Quelle approche de l’IA convient le mieux à votre organisation ? Découvrez les différences entre l’IA locale, l’IA cloud et l’IA hybride, et choisissez l’approche qui répond à vos besoins.

La plus grande opportunité ne réside pas uniquement dans la fourniture de matériel. Les clients ont besoin d’aide pour transformer un système d’IA compact en une solution utile et facile à gérer.
Évaluation et sélection de la charge de travail, du modèle et du système.
Preuve de concept avec des objectifs de qualité et de performance convenus à l’avance.
Installation, segmentation du réseau et renforcement de la sécurité.
RAG privé avec connecteurs, gestion des droits et citation des sources.
Mises à jour des modèles, monitoring, sauvegardes et gestion du cycle de vie.
Formation et assistance pour les développeurs et les utilisateurs finaux.
Configuration hybride avec débordement vers le cloud pour les pics de charge ou les charges de travail plus importantes.
Pour les MSP, cela peut évoluer vers un service de Managed Private AI. Le MSP gère alors la plateforme, les modèles et la disponibilité. L’AI-as-a-Service est également possible, mais nécessite une conception claire en matière d’isolation des clients, de licences, de capacité, de journalisation et de SLA.

Discutez de votre cas d’usage Local AI avec Copaco.

Vous souhaitez parler à un collaborateur Copaco? Appelez-nous +32 053 28 10 00 ou envoyez-nous un e-mail via sales.belgium@copaco.com.