Bespreek jouw Local AI-case met Copaco.
Met Local AI ontwikkelen en draaien klanten AI-modellen binnen hun eigen omgeving, meer controle over data, performance en kosten. Voor resellers een nieuwe categorie tussen de gewone AI-pc en zware datacenterinfrastructuur.

Bij Local AI draait een AI-model op hardware van de organisatie zelf. Het systeem kan op een bureau, in een serverruimte of dicht bij een machine of camera staan. De gegevens hoeven voor iedere vraag, analyse of voorspelling niet naar een externe AI-dienst.
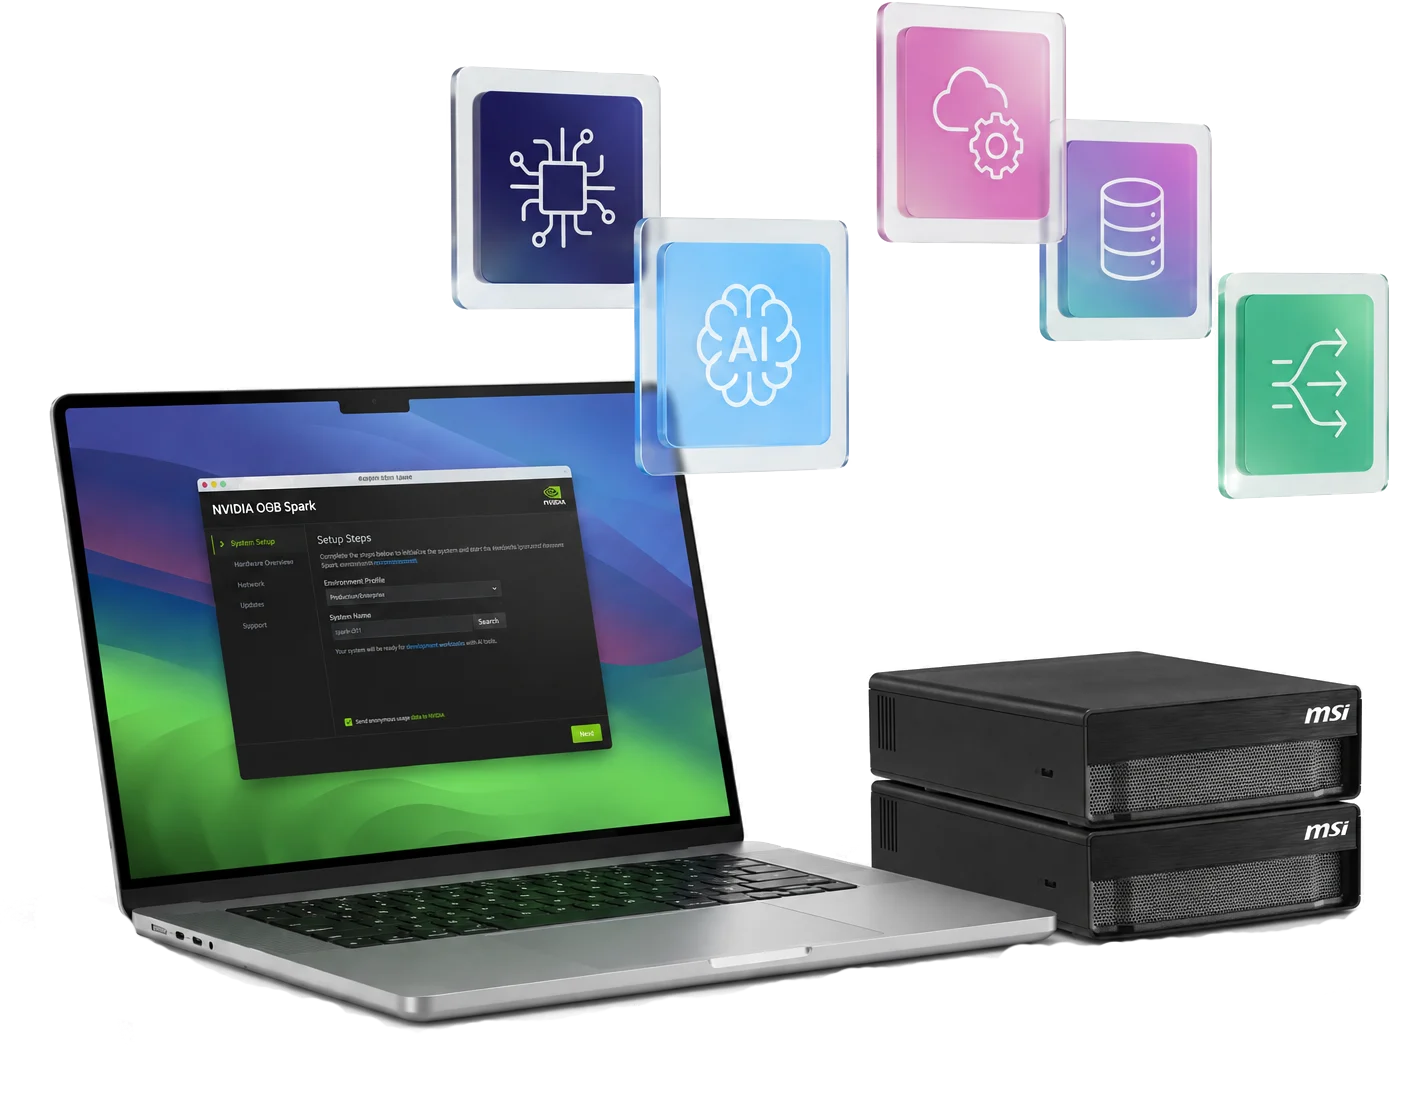
De compacte systemen in deze categorie gebruiken de NVIDIA GB10 Grace Blackwell Superchip. Ze combineren een Arm-processor, een Blackwell-GPU, 128 GB gedeeld geheugen en een AI-softwarestack in één kleine behuizing. Daardoor kunnen ontwikkelaars grotere modellen lokaal testen en gebruiken dan op veel reguliere pc's.
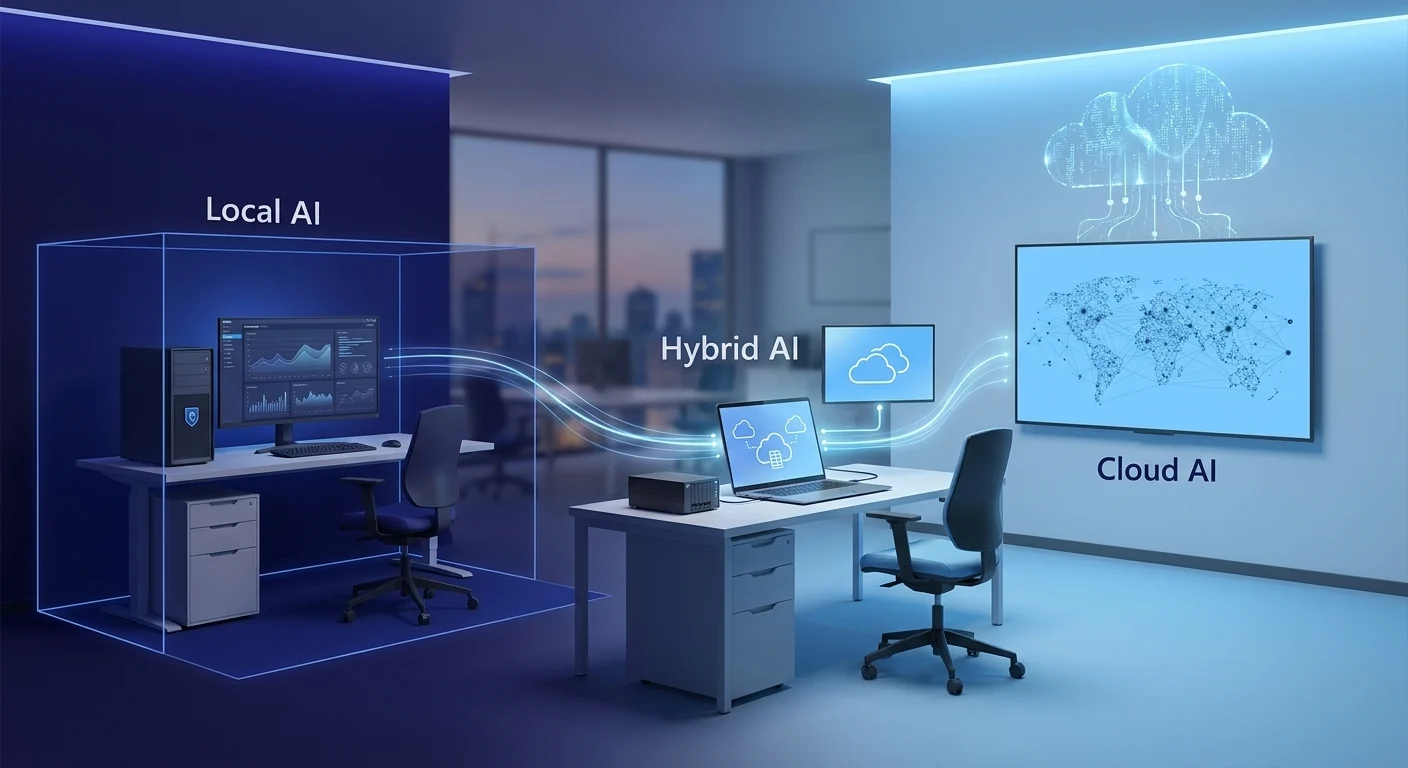
Local AI betekent niet dat de cloud volledig verdwijnt. Modellen, software-updates of externe databronnen kunnen nog steeds een internetverbinding nodig hebben. Ook kan een lokaal ontwikkelde toepassing later naar een datacenter of cloudomgeving worden verplaatst.
Softwarebedrijven, onderzoeksinstellingen en andere organisaties werken vaak met data die zij niet zomaar extern willen verwerken. Door het model en de gegevens lokaal te plaatsen, kunnen zij beter bepalen waar informatie wordt opgeslagen en verwerkt. Lokaal draaien is echter geen automatische garantie voor privacy of compliance. Ook accounts, back-ups, logging, modeldownloads en gekoppelde databronnen moeten veilig worden ingericht. De volledige datastroom blijft bepalend.
Lokale verwerking voorkomt een extra netwerkronde naar een externe omgeving. Dat is interessant wanneer snelle reacties nodig zijn, veel data direct bij een machine ontstaat of de internetverbinding niet altijd betrouwbaar is. Denk aan beeldanalyse in een productieomgeving of een assistent die grote interne documenten doorzoekt. De werkelijke snelheid hangt af van het gekozen model, de hoeveelheid invoer en het aantal gelijktijdige gebruikers. Daarom hoort een praktijktest bij ieder serieus advies.
Cloud-AI en API's rekenen vaak af op basis van gebruik. Dat is flexibel, maar bij dagelijks en intensief gebruik kunnen de kosten sterk wisselen. Een lokaal systeem vraagt een investering vooraf. Daarna zijn hardware, energie, beheer en support beter te begroten. Local AI is niet altijd goedkoper. Bij sporadisch gebruik of grote tijdelijke pieken kan cloudcapaciteit juist aantrekkelijker zijn. Vergelijk daarom de totale kosten over meerdere jaren en neem ook beheer, support en uitwijk mee.
Local AI Supercomputing is vooral relevant voor klanten met een concrete AI-workload en voldoende technisch eigenaarschap:
Softwarebedrijven die broncode, testdata en eigen modellen lokaal willen verwerken.
AI-developers en AI-teams die een vaste omgeving nodig hebben voor ontwikkeling, RAG, inference en fine-tuning.
Onderwijs- en onderzoeksinstellingen die studenten of onderzoekers toegang willen geven tot lokale AI-capaciteit.
Engineeringbedrijven die AI willen inzetten voor beelden, documenten, sensordata of technische workflows.
Organisaties met privacy-, security- of datasoevereiniteitsvereisten.
Organisaties die AI dagelijks gebruiken en meer grip willen op terugkerende gebruikskosten.
Breng het model, de databronnen en de gewenste AI-taak in kaart.
Bepaal hoeveel gebruikers tegelijk werken en welke responstijd nodig is.
Controleer of alle containers, libraries en integraties Arm64 ondersteunen.
Bereken hoeveel opslag nodig is voor modellen, datasets, embeddings, checkpoints en logs.
Leg vast wie security, updates, monitoring, back-up en support beheert.
Vergelijk de totale lokale kosten met een cloud- en hybride scenario.
Test de oplossing met echte klantdata en meet kwaliteit, latency en capaciteit.
Lokale inference is geschikt voor toepassingen zoals samenvatten, classificeren, documentanalyse, code-ondersteuning en interne chatassistenten. Met RAG kan een reseller daar eigen klantinformatie aan toevoegen, bijvoorbeeld handleidingen, projectdocumenten, supporttickets of beleid.
Een goede RAG-oplossing bestaat uit meer dan een taalmodel. Ook documentextractie, zoektechniek, toegangsrechten, bronvermelding en het actueel houden van de kennisbron moeten worden ingericht.
Ontwikkelaars kunnen lokaal modellen vergelijken, prompts testen, agents bouwen en nieuwe toepassingen uitproberen. De vaste ontwikkelomgeving maakt het mogelijk om te experimenteren zonder voor iedere test cloudcapaciteit te starten.
De GB10-systemen draaien op DGX OS en een Arm64-architectuur. Bestaande containers, libraries en bedrijfssoftware moeten daarom vooraf op compatibiliteit worden gecontroleerd.
Met fine-tuning kan een bestaand model worden aangepast voor een domein, schrijfstijl of terugkerende taak. Vooral parameter-efficiënte methoden, zoals LoRA, passen goed bij compacte Local AI-systemen. Volledige training van grote basismodellen vraagt meestal om een zwaardere multi-GPU-omgeving.
Bij computer vision verwerkt AI beelden of video. Voorbeelden zijn kwaliteitscontrole, objectdetectie, OCR en analyse van technische beelden. Lokale verwerking is relevant wanneer videodata niet naar buiten mag of wanneer een snelle reactie nodig is.
Het aantal camera's, de resolutie, het aantal beelden per seconde en het gebruikte model bepalen hoeveel capaciteit nodig is. Test daarom altijd met de echte datastroom.

Een goed advies benoemt ook wanneer een ander platform beter past. Local AI is minder geschikt wanneer:
de klant AI slechts af en toe gebruikt en cloudcapaciteit naar nul kan schalen;
de workload zeer grote of onvoorspelbare pieken kent;
de organisatie grote foundation models volledig wil trainen;
essentiële software alleen op Windows of x86 beschikbaar is;
de dienst direct hoge beschikbaarheid en schaal over meerdere locaties nodig heeft;
niemand verantwoordelijk is voor updates, beveiliging, back-up en modelbeheer.
In zulke situaties kan cloud AI of een hybride oplossing logischer zijn.
De ASUS Ascent GX10, Acer Veriton GN100, MSI EdgeXpert, HP ZGX Nano, Dell Pro Max met GB10 en Lenovo ThinkStation PGX zijn gebaseerd op dezelfde NVIDIA GB10-platformarchitectuur.
De gemeenschappelijke basis bestaat uit een 20-core Arm-processor, een geïntegreerde Blackwell-GPU, 128 GB coherent unified memory en NVIDIA DGX OS. NVIDIA specificeert tot 1 PFLOP AI-performance bij FP4 met sparsity. Eén systeem wordt gepositioneerd voor modellen tot 200 miljard parameters. Twee gekoppelde systemen kunnen grotere modellen tot 405 miljard parameters ondersteunen.
Deze getallen vragen uitleg; de 1 PFLOP is een theoretische piekwaarde bij een specifieke precisie. Het aantal parameters zegt vooral of een model in de beschikbare omgeving kan passen. Het is geen garantie voor snelheid, kwaliteit of het aantal gebruikers dat het systeem aankan.
Systeem | Opslagvarianten* | Relevant onderscheid | Selecteer vooral op |
|---|---|---|---|
ASUS Ascent GX10 | 1, 2 of 4 TB | Meerdere opslagopties en eigen thermisch ontwerp. | SKU, opslag en support. |
Tot 4 TB | Bepaalde SKU's bevatten een QSFP-kabel en toetsenbord. | Exacte bundel en beschikbaarheid. | |
1 of 4 TB | Edge/industrial-positionering en optionele rackmontage. | Plaatsing, koeling en accessoires. | |
1 of 4 TB | HP ZGX Toolkit; desktop- en edgegebruik. | Software, support en opslag. | |
1, 2 of 4 TB | Brede SSD-keuze en gedocumenteerde vervangbare SSD. | SSD-type, service en support. | |
1 of 4 TB | DGX OS, AI Workbench en ThinkStation-positionering. | Beheer, bundel en support. |
*Configuraties, meegeleverde accessoires en beschikbaarheid kunnen per land en partnummer verschillen.
Op basis van de officiële specificaties is er geen goede grond om één merk als structureel sneller te presenteren. Voor reseller en eindklant zijn opslag, koeling, bundel, garantie, support, beheer en levertijd waarschijnlijk belangrijker.
Welke AI-aanpak past het beste bij jouw organisatie? Ontdek de verschillen tussen Local AI, Cloud AI en hybride AI en kies de aanpak die aansluit op jouw behoeften.

De grootste kans ligt niet alleen in de levering van hardware. Klanten hebben hulp nodig om van een compact AI-systeem een bruikbare en beheersbare oplossing te maken.
Assessment en selectie van workload, model en systeem.
Proof of concept met vooraf afgesproken kwaliteits- en prestatiedoelen.
Installatie, netwerksegmentatie en security-hardening.
Private RAG met connectors, rechten en bronvermelding.
Modelupdates, monitoring, back-up en lifecyclebeheer.
Training en ondersteuning voor ontwikkelaars en eindgebruikers.
Hybride inrichting met cloud-uitwijk voor pieken of grotere workloads.
Voor MSP's kan dit uitgroeien tot een Managed Private AI-dienst. Daarbij beheert de MSP het platform, de modellen en de beschikbaarheid. AI-as-a-Service is eveneens mogelijk, maar vraagt een helder ontwerp voor klantisolatie, licenties, capaciteit, logging en SLA's.

Bespreek jouw Local AI-case met Copaco.

Een medewerker van Copaco spreken? Bel 040 2306 306, whatsapp Copaco Nederland of email via contactcenter@copaco.com.